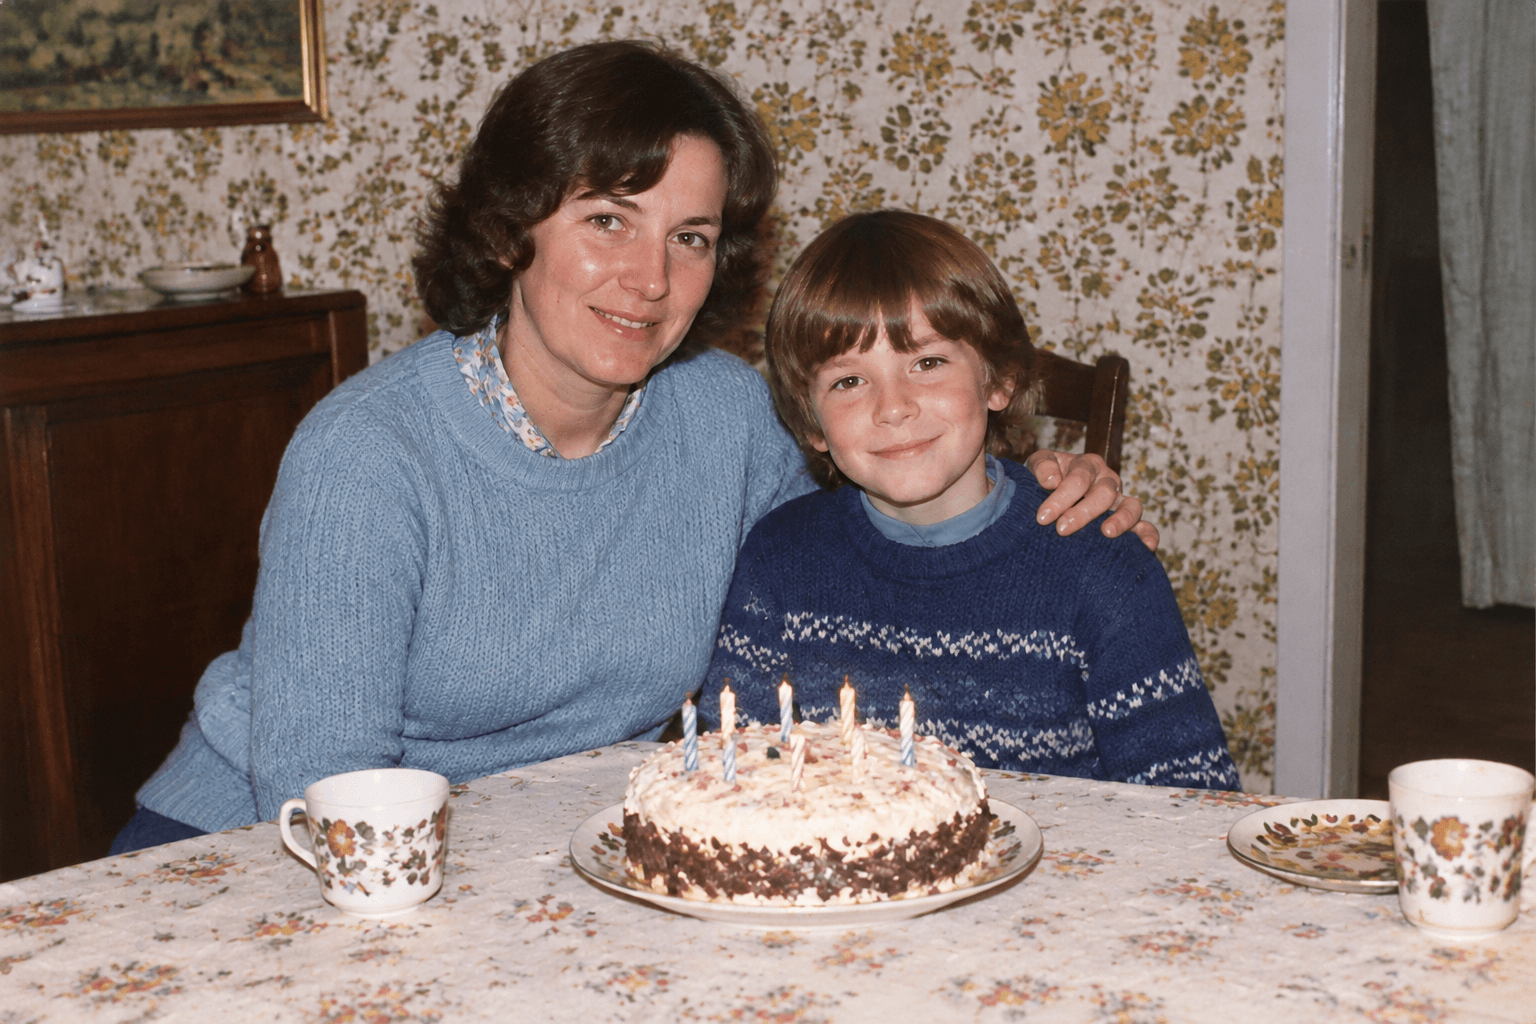 修复后的照片
让一张年代久远的老照片“动起来”,我们的初衷通常不是为了还原一段真实的录像,而是带着一种美好的情感寄托——想看看照片里的亲人能不能再次轻轻微笑、点头或是向我们挥手。
需要先了解的是,AI 动画模型会根据静态照片的现有像素来推测运动轨迹,因此生成的是一段“全新的视觉创作”。它可以让原本静止的画面极具表现力和生命力,但这并不代表照片之外的动作在当年真实发生过。
如果你是第一次尝试让照片动起来,记住一个核心秘诀:动作越简单,结果越自然,也越容易判断效果。
第一步:什么样的老照片最适合“动起来”?
并不是所有照片都适合立刻生成视频。比较容易获得优质动画效果的照片,通常具备以下特点:
- 主体清晰:人物的五官轮廓完整,脸部没有被强光、浓重阴影或其他物体严重遮挡。
- 肢体明确:手部和身体的相对位置比较容易辨认,没有复杂的姿势交叠。
- 背景干净:照片背景没有严重的破损或极其复杂的线条。
- 重叠较少:单人半身照通常最容易处理和检查。多人照片也可以尝试,但人物越多、身体遮挡越严重,设定的动作幅度就应该越小。
第二步:如何编写精准的“动作提示词”?
写好 AI 视频生成的动作提示词(Prompt),不需要华丽的辞藻。你只需要清晰地回答这三个问题:谁在动?做什么动作?哪些内容必须保持不变?
推荐的提示词句式:
对于初次尝试,最好只安排一个核心动作。例如:单纯的微笑、点头、挥手或轻轻转头。单一动作远比“多人互动、镜头复杂旋转、大幅度改变姿势”更容易被 AI 准确执行,也更容易让你查验结果。
避坑指南:千万不要一次性塞入太多动作
以下是一种极其容易翻车的提示词写法:
如果按照上述指令生成,一旦视频结果出现扭曲或不自然,你根本无法分辨是哪一个动作导致的。更好的方式是“拆解动作”:先测试一个小动作(比如相视微笑),如果效果自然,再根据结果决定是否要在下一次生成中增加新的变化。
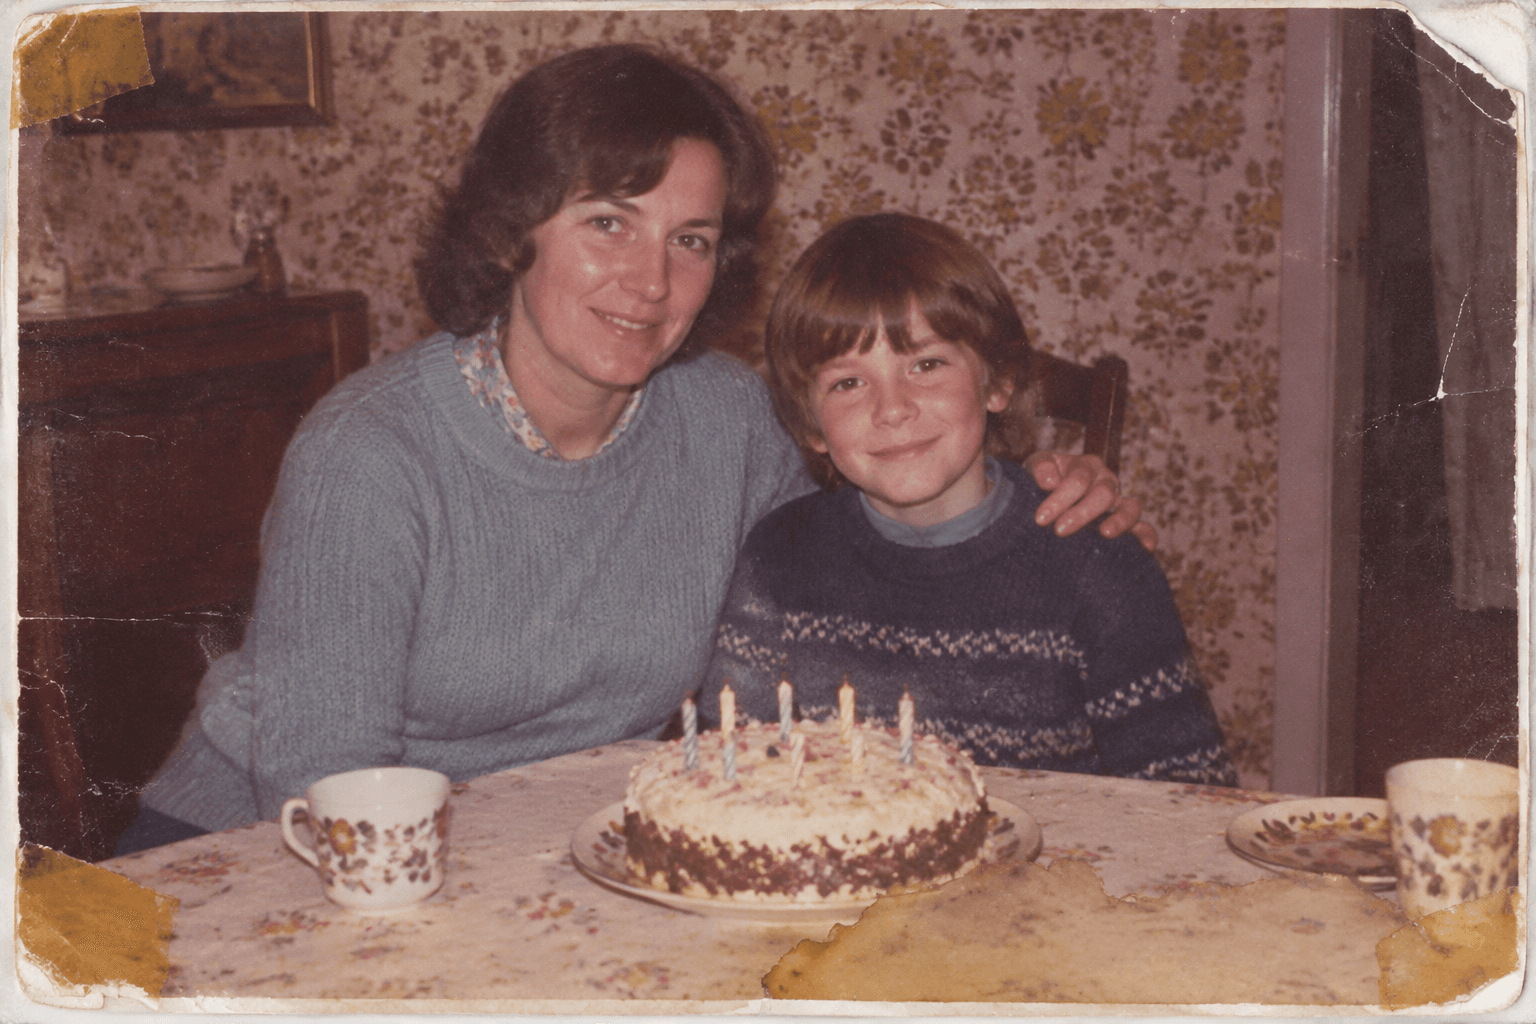 输入静态图
第三步:生成后,按这“两步走”检查效果
第一遍:整体观感连贯性(不暂停)
- 动作是否丝滑,有没有突然的抽搐或跳帧?
- 镜头的距离和透视关系有没有发生不合理的形变?
- 人物与人物之间、人物与环境之间的空间关系是否稳定?
- 整体的情感表达是否自然温馨?
第二遍:暂停逐帧检查细节(细节放大镜)
- 面部:脸型和眼睛在运动过程中有没有发生变形?(AI 生成视频最容易在眨眼时改变眼型)
- 肢体与衣物:手指数量是否正确?衣服纹理、眼镜和帽子在运动时有没有出现闪烁或融化现象?
- 背景边缘:背景的墙面、文字或照片边缘,有没有因为人物的移动而凭空生出奇怪的结构?
- 多人物接触位置(如牵手、搭肩膀)是否在运动中保持稳定?
进阶须知:修复与动画应该怎样配合?
静态修复(去划痕、褪色上色、面部增强)和动态生成是两道不同的工序。修复是为了解决破损,让老照片更容易被“看清”;动画是为了解决静止,让画面产生新的“生机”。
如果你的老照片受损严重,正确的流程是先完成静态修复,再判断修复后的图是否适合做动画。注意:一定要先通过“前后对比”确认静态修复的脸部是准确的。千万不要因为照片动起来看着很神奇,就误以为 AI 修复的面部特征一定完全还原。
常见问题
一条提示词里最多可以写几个动作?
第一次生成建议只写一个主要动作(如微笑),并补充需要保持不变的元素(如脸部、衣服、背景)。确认单动作效果好之后,再尝试复合动作。
哪些照片不适合一开始就做“转身”或“奔跑”这样的大幅动作?
如果人物脸部原本就不可见、多人严重重叠、关键区域缺失,或者动作要求超出了静态照片能提供的常识线索(比如照片只拍到肩膀,却要求人物跳舞),都不适合做大幅动作。建议从微笑、眨眼等微表情开始。
动画结果不自然时,我应该先改提示词,还是先换照片?
先检查原图。如果输入照片过暗、反光严重或清晰度极差,AI 就无法准确捕捉肢体关节和五官。这种情况下,换一张更清晰、光线更好的照片,比反复修改提示词有效得多。
动画里人物的动作,是当年真实发生过的吗?
不是。AI 动画是模型根据静态像素进行的艺术化推测与视觉创作,不能作为证明当年发生过该动作的历史证据。